DGX GB300 NVL72 CX8 floor feed rack with Business Std Support, 3 Years
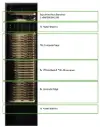
NVIDIA GB300 NVL72 to w pełni chłodzona cieczą platforma klasy rack-scale, integrująca 72 procesory graficzne NVIDIA Blackwell Ultra (GPU) oraz 36 procesorów NVIDIA Grace opartych na architekturze Arm® w jednym zintegrowanym systemie.
INI – Installation Included / Integrated Installation – w pakiecie znajduje się usługa uruchomienia lub fabrycznej integracji wykonywana przez autoryzowanego partnera FORMAT Sp. z o.o..
Oprogramowanie zapewnia:
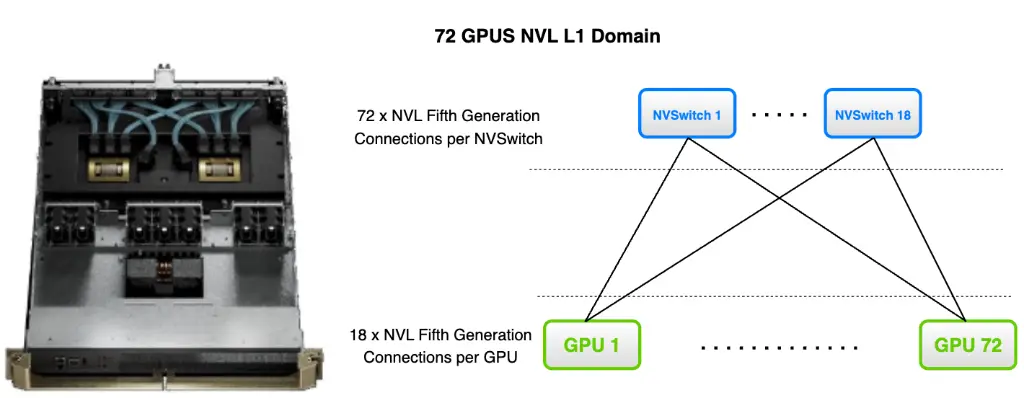
- pełną komunikację GPU–GPU w obrębie 72 procesorów GPU,
- komunikację pomiędzy wieloma szafami DGX GB300 poprzez Multi-Node NVLink (MNNVL),
- sprzętowo przyspieszaną komunikację kolektywną (NCCL, NVSHMEM, NVLink SHARP),
- izolację wielu użytkowników i wielu zadań,
- zarządzanie topologią NVLink przez Fabric Manager,
- monitorowanie systemu z wykorzystaniem DCGM oraz telemetrii ConnectX-8,
- automatyzację konfiguracji przy użyciu kolekcji Ansible.
Są to funkcje charakterystyczne dla infrastruktury przeznaczonej do trenowania i wnioskowania z wykorzystaniem bardzo dużych modeli AI (LLM) oraz środowisk HPC nowej generacji.
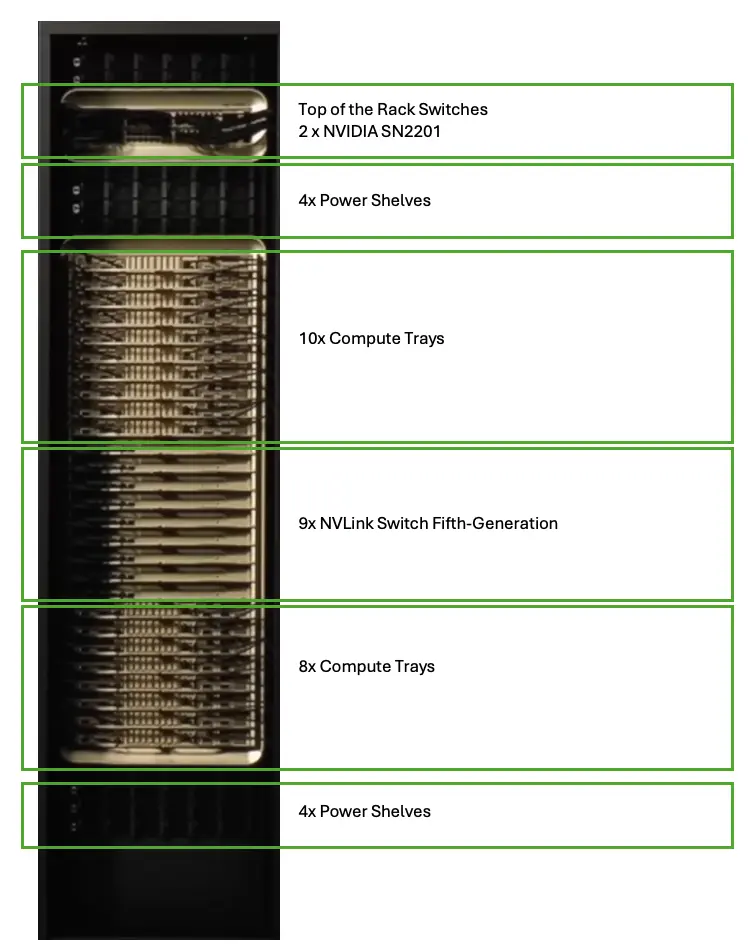
- wysokość ok. 52U,
- chłodzenie cieczą (Direct Liquid Cooling),
- 72 procesory GPU Blackwell Ultra oraz 36 procesorów Grace,
- moc elektryczna całej szafy dochodząca do ok. 140–142 kW.
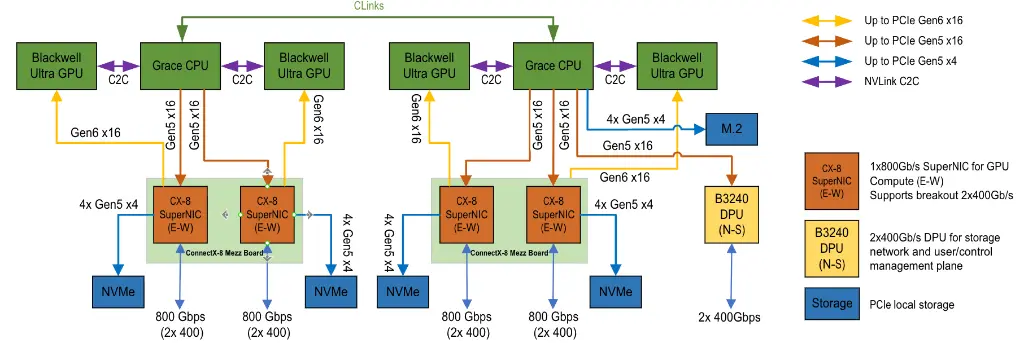
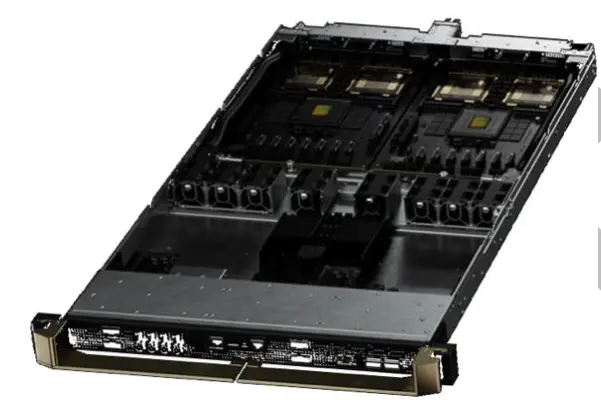
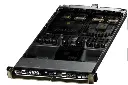
- 4 × NVIDIA Blackwell Ultra GPU,
- 2 × NVIDIA Grace CPU,
- 4 × ConnectX-8 HCA,
- 1 × BlueField-3 DPU,
- lokalne dyski NVMe E1.S.
- szybkozłącza cieczy,
- kolektory chłodzące,
- wymienne moduły (tray),
- bardzo duża gęstość upakowania komponentów.
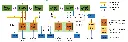
- 9 modułów NVSwitch,
- pełna topologia all-to-all pomiędzy wszystkimi 72 GPU,
- przepustowość NVLink wynosząca 130 TB/s.
Kod kreskowy:
DGB3-0072F+P2CMI36
Specyfikacje
NVIDIA GB300 NVL72¹
| Configuration | 72 NVIDIA Blackwell Ultra GPUs, 36 NVIDIA Grace CPUs |
| NVLink Bandwidth | 130 TB/s |
| Fast Memory | 37 TB |
| GPU Memory | Bandwidth | 20 TB | Up to 576 TB/s |
| CPU Memory | Bandwidth | 17 TB LPDDR5X | 14 TB/s |
| CPU Core Count | 2,592 Arm Neoverse V2 cores |
| FP4 Tensor Core | 1440 | 10802 PFLOPS |
| FP8/FP6 Tensor Core | 720 PFLOPS |
| INT8 Tensor Core | 24 POPS |
| FP16/BF16 Tensor Core | 360 PFLOPS |
| TF32 Tensor Core | 180 PFLOPS |
| FP32 | 6 PFLOPS |
| FP64 / FP64 Tensor Core | 100 TFLOPS |
1. All Tensor Core specifications are with sparsity unless otherwise noted. 2. Without sparsity. |
Read the NVIDIA Blackwell Ultra Datasheet
1. Maksymalne wartości bazują na podkręceniu rdzenia GPU (boost clock).
2. Teoretyczna wydajność FP4 w TOPS przy użyciu funkcji sparsity.